Inteligência Artificial · openai
OpenAI revela como combate a 'destilação adversarial', técnica usada para copiar modelos de IA sem as travas de segurança
Empresa diz que blindou o raciocínio interno do GPT-6.2 Astra e Sol: em teste interno, a taxa de sucesso de ataques para extraí-lo caiu de 54% para 0,2%. Estudo mostra que cadeias de raciocínio ensinam habilidades de ciberataque a modelos 'alunos'.
A cópia de modelos de inteligência artificial deixou de ser apenas uma disputa de propriedade intelectual e virou um problema de segurança, segundo a OpenAI. Em texto publicado na sexta-feira (20), a empresa detalhou como enfrenta a chamada destilação adversarial e quais lições pretende compartilhar com o resto da indústria.
O que é destilação — e por que preocupa
Destilação é uma técnica comum de aprendizado de máquina em que um modelo aprende com dados produzidos por outro: com suas respostas, seu raciocínio ou seus julgamentos sobre quais respostas são melhores. No jargão, quem gera os dados é o "professor", e quem aprende é o "aluno". O problema surge quando isso é feito sem autorização, a partir de um modelo de ponta, para criar outro com capacidades semelhantes, mas sem as salvaguardas originais.
"Um adversário pode destilar as capacidades cibernéticas de um modelo e usar o modelo resultante para ajudar a realizar ciberataques que o modelo original teria se recusado a apoiar ou que suas salvaguardas teriam bloqueado", escreve a empresa. A preocupação é maior em áreas de uso duplo: um modelo que ajuda defensores a encontrar falhas em software pode ajudar um atacante a explorá-las; um que auxilia pesquisas em biologia pode ajudar alguém a desenvolver um patógeno.
O raciocínio como alvo
A OpenAI dá ênfase especial ao que chama de raciocínio protegido: os passos intermediários que o modelo gera internamente antes de chegar a uma resposta, a chamada cadeia de pensamento. Esses rastros podem conter informações que a resposta final omite e, por isso, são dados de treinamento especialmente valiosos para um copiador.
Para medir o risco, a empresa fez um estudo interno. Partindo sempre do mesmo modelo pré-treinado, criou alunos ajustados com trajetórias de modelos do nível Astra trabalhando em tarefas de programação e de cibersegurança defensiva — tarefas permitidas pelas regras de uso. Um aluno recebeu apenas o conteúdo normalmente visível aos usuários, como respostas finais, resumos do raciocínio e interações com ferramentas; outro teve acesso ao raciocínio exato. Depois do ajuste fino, o aluno treinado com o raciocínio exato geralmente se saiu melhor. Após uma rodada leve de aprendizado por reforço, ele continuou à frente no maior orçamento de inferência testado, enquanto o treinado com resumos foi melhor em orçamentos menores.
A conclusão da empresa é que, mesmo quando a tarefa original é benigna, acumular muitos rastros exatos de raciocínio pode ensinar ao aluno habilidades que vão além do que o professor fez — inclusive habilidades ofensivas.
Como a OpenAI se defende
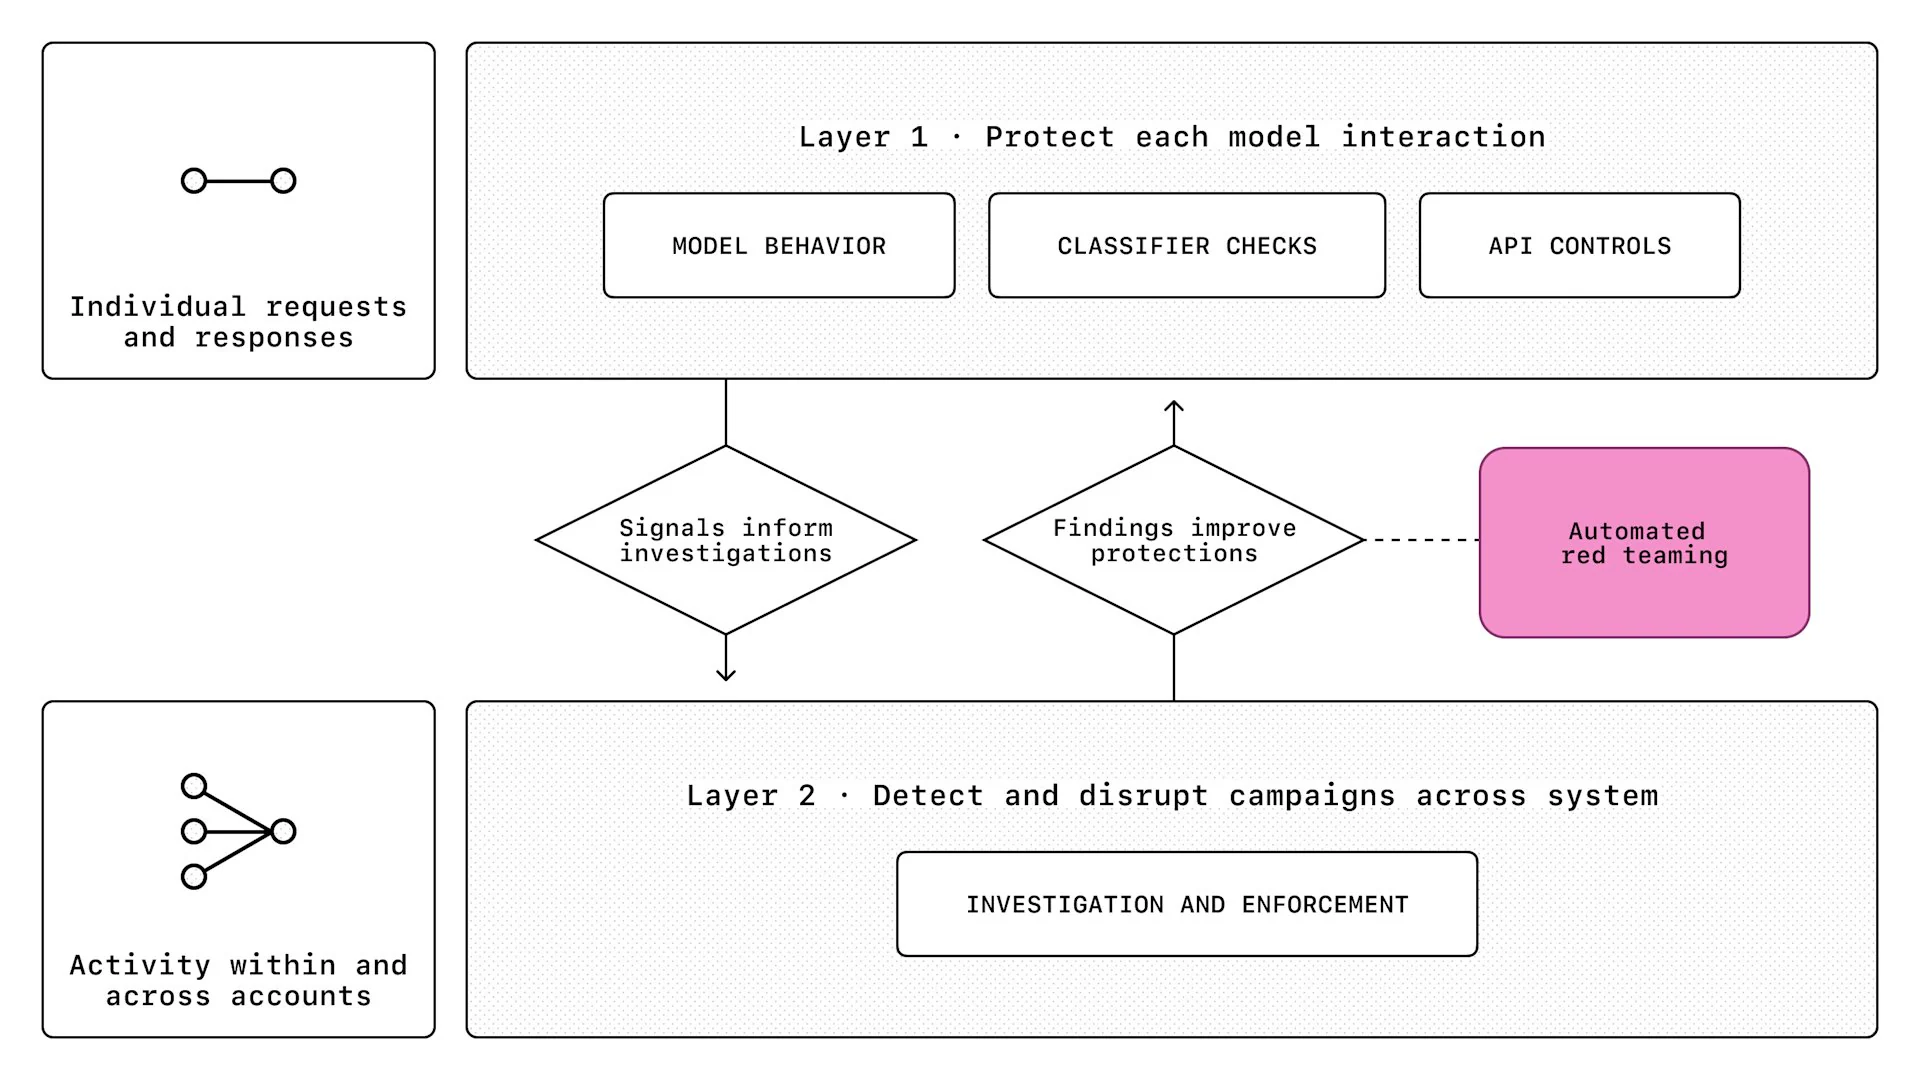
As defesas funcionam em dois níveis. No nível de cada requisição, o modelo é treinado de forma adversarial para reconhecer tentativas de extrair seu raciocínio e se recusar a revelá-lo, sem deixar de explicar coisas quando o pedido é legítimo. Os exemplos de treino vêm de ataques bem-sucedidos encontrados por equipes automatizadas de red team, por investigações e por relatos de pesquisadores externos. Classificadores de entrada detectam tentativas de extração, e classificadores de saída procuram vazamentos tanto nas mensagens quanto nos argumentos de chamadas de ferramentas — já que um modelo pode expor o raciocínio num parâmetro de ferramenta sem incluí-lo na resposta final.
Na API, a empresa diz ter fechado brechas descritas em setembro, quando atacantes moviam o raciocínio criptografado de uma conversa para outra e pediam ao modelo que o revelasse em texto legível — incluindo um caminho que poderia expor o raciocínio criptografado de outro usuário. No GPT-6.2 Astra e no GPT-6.2 Sol, o raciocínio fica atrelado ao histórico da conversa que o produziu: se uma mensagem anterior for reescrita, a API descarta o raciocínio que veio depois. Modelos de famílias mais antigas, com proteções mais fracas, também não conseguem mais ler esse raciocínio. Num teste interno com red team automatizado, a taxa média de sucesso dos ataques caiu de 54% contra o GPT-6 Astra com as proteções originais para 0,2% contra o GPT-6.2 Astra.
No nível de campanha, a OpenAI procura padrões em sinais de requisições e contas que revelem tentativas coordenadas de extração. Quando encontra violações, pune toda a rede de contas envolvida e usa os ataques descobertos para treinar e testar as defesas. A empresa diz ainda compartilhar indicadores de comprometimento com outros fornecedores de modelos e defende padrões comuns de proteção entre as plataformas que oferecem seus modelos.
O tema ganhou peso político e comercial nos últimos anos, com laboratórios americanos acusando concorrentes, sobretudo chineses, de treinar modelos abertos a partir de respostas de sistemas fechados. A OpenAI não cita empresas específicas no texto.
Fontes
Assuntosinteligencia artificialopenaiseguranca digitalmodelos de ia